Resources / SEO-starterkit

Leer SEO.
Eén tool tegelijk.

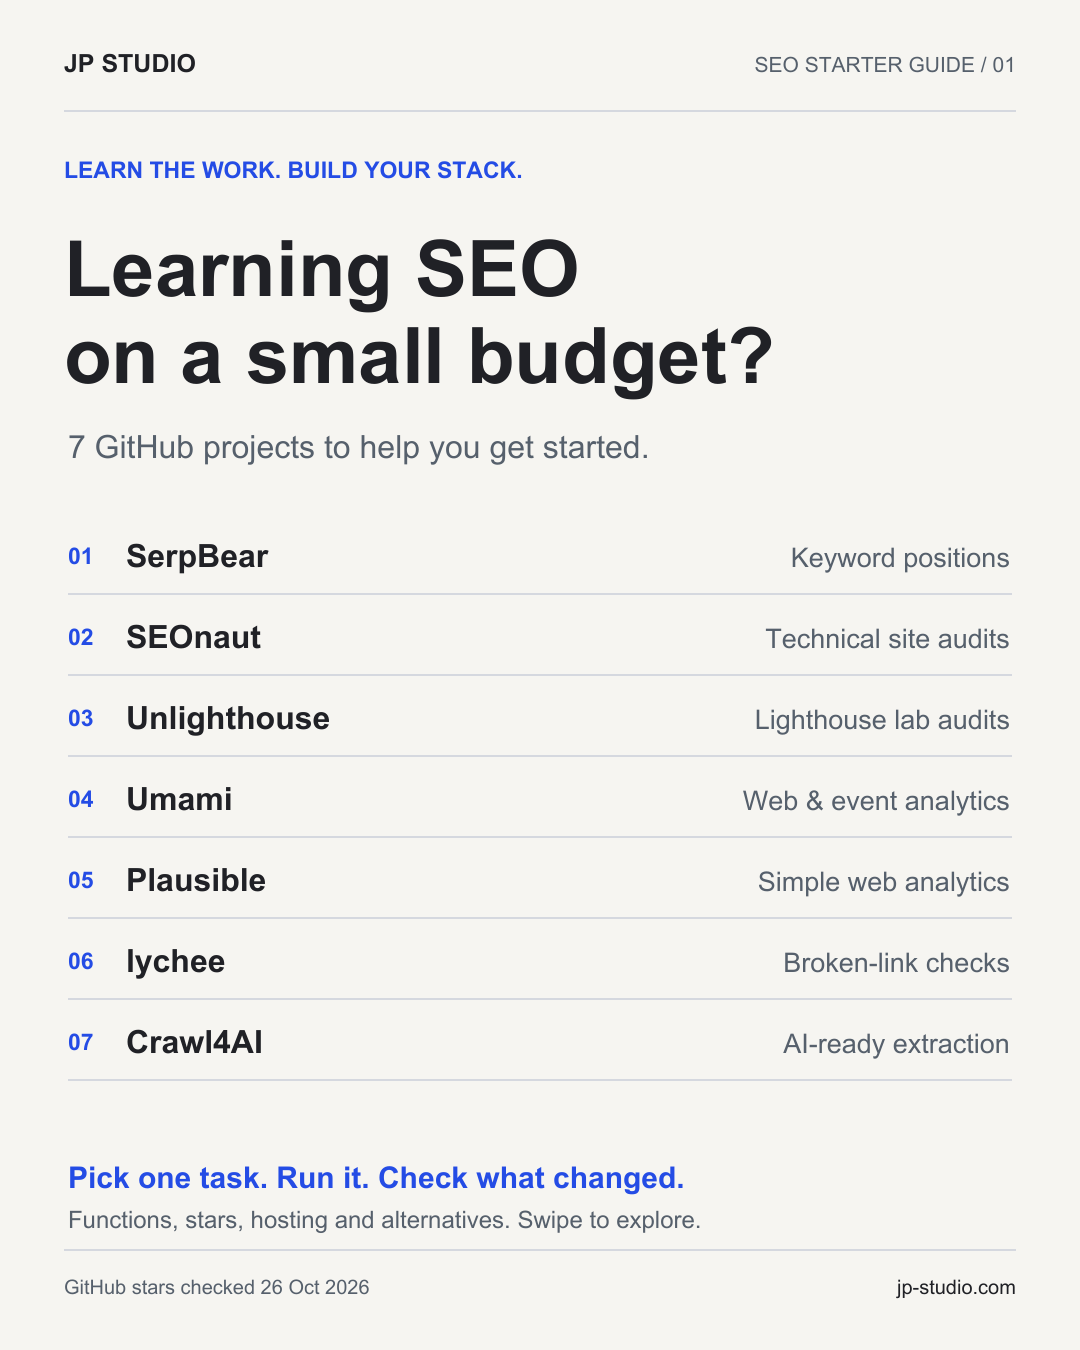
Zeven open-source projecten voor een klein budget. Ontdek wat elke tool doet, kies een nuttige eerste taak en leer door het te proberen.

PDF · Engels · geen e-mailadres nodig

GitHub / Open sourceLinks, licenties en sterren gecontroleerd op 26 oktober 2026.

01 / Begin met een taak

Wat wil je
als eerste begrijpen?

Begin met de vraag die je wilt beantwoorden. Je hoeft niet alle tools te installeren.

02 / De toolkit

Vind je startpunt.

De verschillen die ertoe doen, de installatie en een eerste oefening. Open een tool voor de details.

GitHub-sterren zijn gecontroleerd op 26 oktober 2026. Het zijn momentopnamen per repository, geen kwaliteits- of veiligheidsscore.

01

Zoekwoordposities

SerpBear

Een zelfgehoste applicatie om ingestelde zoekwoorden en domeinen in Google-resultaten te volgen.

towfiqi/serpbear
2,142GitHub-sterrenMITLicentie
Installatie & eerste oefening

Handig wanneer

Je hebt een kleine selectie belangrijke zoekopdrachten en wilt hun posities over tijd vergelijken.

Je eerste taak

  1. Lees de actuele documentatie en kies eerst een ondersteunde bron voor zoekresultaten.
  2. Voeg je eigen domein en enkele zoekwoorden toe, met hetzelfde land en dezelfde taal.
  3. Bewaar een nulmeting en vergelijk volgende controles met dezelfde instellingen.

Waar draait het?

Zelfgehoste Next.js-applicatie met SQLite; Docker wordt ondersteund.

Waar moet je op rekenen?

Houd rekening met hosting en een ondersteunde SERP-provider of proxyservice. Open-source software maakt het verzamelen van zoekresultaten niet kosteloos. Oudere provider-voorbeelden werken mogelijk niet meer.

Vergelijk voor deze taak

SE Ranking

Vergelijkbaar voor het volgen van zoekwoordposities.

De grens: Dit is geen vervanging voor een volledige SEO-suite, backlinkindex of zoekwoorddatabase.

02

Technische site-audits

SEOnaut

Een crawler die technische bevindingen, zoals kapotte links, redirects en metadataproblemen, omzet in een lijst om te onderzoeken.

StJudeWasHere/seonaut
838GitHub-sterrenMITLicentie
Installatie & eerste oefening

Handig wanneer

Je wilt een crawlrapport leren lezen en controleren of een concrete aanpassing een bevinding oplost.

Je eerste taak

  1. Volg de instructies in de repository, inclusief het instellen van de database.
  2. Crawl een kleine site die je beheert en kies één bevinding, zoals een ontbrekende titel of interne 404.
  3. Bekijk de betreffende pagina, herstel het probleem en controleer opnieuw.

Waar draait het?

Zelfgehoste Go-applicatie met MySQL; de makers raden Docker Compose aan.

Waar moet je op rekenen?

Reken op een server, database, back-ups, updates en onderhoud. Een eigen installatie vraagt ander werk dan een beheerde crawlerdienst.

Vergelijk voor deze taak

Screaming Frog SEO Spider

Vergelijkbaar voor crawlen en technische controles.

De grens: Functies verschillen, onder meer bij rendering en integraties. Screaming Frog heeft ook een beperkte gratis versie: vergelijk eerst wat je nodig hebt.

03

Lighthouse-labtests

Unlighthouse

Ontdekt pagina’s en voert Lighthouse-tests uit, zodat je resultaten binnen een site kunt vergelijken.

harlan-zw/unlighthouse
4,915GitHub-sterrenMITLicentie
Installatie & eerste oefening

Handig wanneer

Je wilt paginatemplates onder dezelfde testomstandigheden vergelijken en onderzoeken waar verschillen ontstaan.

Je eerste taak

  1. Volg de installatie-eisen van de gekozen versie, inclusief de vereiste Node.js-versie.
  2. Begin met een kleine mobiele labtest op eigen pagina’s en beperk gelijktijdige tests.
  3. Onderzoek één rapport, pas gericht iets aan en herhaal onder dezelfde omstandigheden.

Waar draait het?

Lokaal met Node.js en Chromium, of op een geschikte CI-runner.

Waar moet je op rekenen?

Lokale tests gebruiken de CPU en het geheugen van je computer. CI-tests gebruiken runnercapaciteit. Voor een lokale Lighthouse-test is geen betaalde PageSpeed-API-sleutel nodig.

Vergelijk voor deze taak

DebugBear

Vergelijkbaar voor het Lighthouse-labtestdeel van het werk.

De grens: Het is niet dezelfde beheerde monitoringdienst en vervangt geen metingen bij echte bezoekers of alle wereldwijde monitoringfuncties.

04

Bezoekers en events

Umami

Een analytics-applicatie voor bezoeken, verwijzende bronnen, campagnes en events die je zelf kiest om te meten.

umami-software/umami
39,705GitHub-sterrenMITLicentie
Installatie & eerste oefening

Handig wanneer

Je wilt leren waar bezoekers vandaan komen en of zij een nuttige actie uitvoeren, zoals klikken op een contactknop.

Je eerste taak

  1. Volg de actuele installatie-instructies en koppel de vereiste PostgreSQL-database.
  2. Voeg een eigen site en de bijbehorende trackingcode toe.
  3. Maak een testbezoek, voer een eenvoudige actie uit en controleer wat er in het rapport verschijnt.

Waar draait het?

Een Node.js-applicatie met PostgreSQL; een Docker-configuratie is beschikbaar.

Waar moet je op rekenen?

Zelf hosten vraagt app- en databasecapaciteit, back-ups, upgrades en onderhoud. Umami heeft ook een hosted dienst met eigen pakketten. Let op welke gegevens je in events meestuurt.

Vergelijk voor deze taak

Fathom

Vergelijkbaar voor bezoekers- en eventanalytics.

De grens: Functies en dienstverlening zijn niet identiek. Ook Umami Cloud en een eigen Umami-installatie verschillen.

05

Overzichtelijke analytics

Plausible Community Edition

De zelfgehoste Community Edition van Plausible, met een gericht overzicht van verkeer, acquisitiebronnen en doelen.

plausible/analytics
29,669GitHub-sterrenAGPL-3.0-or-later application; MIT JavaScript tracker.Licentie
Installatie & eerste oefening

Handig wanneer

Je wilt een klein analyticsdashboard en kunt de applicatie en databases zelf beheren.

Je eerste taak

  1. Gebruik de Community Edition-installatierepository en lees de actuele systeemeisen.
  2. Voeg een eigen site toe en volg de trackinginstructies.
  3. Controleer een testbezoek, een verwijzende bron en één nuttig doel voordat je op de rapporten vertrouwt.

Waar draait het?

Een zelfgehoste Docker Compose-stack met PostgreSQL en ClickHouse.

Waar moet je op rekenen?

Budgetteer de server, beide databases, back-ups, updates en beheertijd. De Community Edition en betaalde Cloud-dienst hebben verschillende functies.

Vergelijk voor deze taak

Plausible Cloud

Vergelijkbaar voor de basis van websiteanalytics.

De grens: Community Edition mist Cloud-functies, zoals funnels, user journeys, omzetdoelen voor e-commerce en SSO. Ook ondersteuning en beheer verschillen.

06

Kapotte links controleren

lychee

Een commandline-linkchecker voor Markdown, HTML, tekstbestanden en URL’s. Een aparte GitHub Action kan controles in een repository herhalen.

lycheeverse/lychee
4,049GitHub-sterrenMIT OR Apache-2.0, at your option.Licentie
Installatie & eerste oefening

Handig wanneer

Je onderhoudt documentatie of een repository en wilt mislukte links vóór of na een wijziging onderzoeken.

Je eerste taak

  1. Volg de CLI-documentatie en controleer eerst een kleine selectie eigen bestanden.
  2. Bekijk een mislukte link ook handmatig: limieten en tijdelijke fouten kunnen op een kapotte link lijken.
  3. Als de lokale controle nuttig is, kun je de GitHub Action voor pull requests of een passend schema overwegen.

Waar draait het?

Op je computer of een GitHub Actions-runner; een permanente webserver is niet nodig.

Waar moet je op rekenen?

Lokale controles gebruiken je computer en verbinding. GitHub Actions kan betaalde runnerminuten gebruiken, afhankelijk van repository, pakket en workflow.

Vergelijk voor deze taak

Dr. Link Check

Vergelijkbaar voor linkcontroles en foutmeldingen.

De grens: Het is niet dezelfde beheerde plannings- of rapportagedienst en geen volledige website-audit. Links die met JavaScript ontstaan kunnen extra controle vragen.

07

Webinhoud voor AI-workflows

Crawl4AI

Een Python-tool die pagina’s rendert en inhoud als Markdown of gestructureerde gegevens ophaalt voor een volgende onderzoeks- of AI-stap.

unclecode/crawl4ai
86,293GitHub-sterrenApache-2.0. Retain applicable notices and attribution, and consult the upstream licence and README.Licentie
Installatie & eerste oefening

Handig wanneer

Je wilt werken met enkele openbare documentatiepagina’s en de broninhoud controleren voordat je die in een workflow gebruikt.

Je eerste taak

  1. Volg de actuele SDK- en browserinstallatie, of de documentatie voor een eigen Docker-dienst.
  2. Haal enkele pagina’s op waarvoor je toegang hebt, eerst zonder optionele modelgestuurde extractie.
  3. Vergelijk de uitvoer met de bronpagina’s en bewaar de originele URL’s voordat je verdergaat.

Waar draait het?

Lokaal met Python en browserafhankelijkheden, of als zelfgehoste Docker-dienst.

Waar moet je op rekenen?

De crawler en CSS-extractie hebben geen LLM-sleutel nodig. Browsers, servers, proxy’s en optionele modelaanroepen kunnen wel geld kosten. Je beheert de infrastructuur zelf.

Vergelijk voor deze taak

Firecrawl

Vergelijkbaar voor het ophalen en structureren van webinhoud.

De grens: Het is geen gelijkwaardige beheerde clouddienst, proxy-infrastructuur, zoekindex of complete SEO-suite.

03 / Leer door te doen

Een rapport is een beginpunt.

Neem één bevinding mee tot een gecontroleerd resultaat.

  1. 01

    Kies één site of repository die je beheert en één vraag die je wilt beantwoorden.

  2. 02

    Voer de controle of een testbezoek uit. Bewaar de datum en instellingen bij het resultaat.

  3. 03

    Onderzoek één bevinding, pas gericht iets aan en controleer opnieuw.

  4. 04

    Noteer wat veranderde en wat nog onzeker is voordat je de workflow uitbreidt.

Een gids om te bewaren

Bewaar de links.
Probeer één ding.

De gratis PDF bundelt de repositorylinks, functies en eerste oefeningen. Je kunt deze pagina altijd teruglezen, zonder account, e-mailformulier of community.

Download de gidsPDF · Engels · geen e-mailadres nodig
Omslag van de gids met zeven open-source SEO-tools

04 / Een paar nuttige verschillen

Voordat je iets installeert.

Zijn deze tools helemaal gratis in gebruik?

Open-source code neemt de kosten van hosting, databases, dataproviders en onderhoud niet weg. Lokale tools gebruiken je eigen computer; zelfgehoste applicaties vragen doorlopend beheer. De kosten per tool staan hierboven.

Heb ik alle zeven nodig?

Nee. Kies een tool voor de taak die je wilt oefenen. Umami en Plausible overlappen, terwijl Crawl4AI zich op webextractie richt en geen algemene SEO-audit is.

Vervangen ze een complete betaalde SEO-suite?

De vergelijkingen gaan over specifieke taken. Een ranktracker, crawler of linkchecker biedt niet automatisch iedere databron, integratie, ondersteuning of monitoringfunctie van een betaalde suite.

Is seo-unlighthouse hetzelfde project als Unlighthouse?

Nee. Unlighthouse is de audit-engine. De skill seo-unlighthouse is een optionele wrapper in de aparte Haniubub/seo-toolkit-repository, met eigen installatie- en versie-eisen.

Meer praktische uitleg over AI, code en automatisering.

Volg @madebyjpstudio op Instagram

Gemaakt door JP Studio

Wij ontwerpen en bouwen digitale producten, AI-assistenten en bedrijfsautomatiseringen. Deze gids helpt je op weg; het is geen claim dat wij elk project gebruiken of getest hebben.

Bekijk AI & automatisering